Formation IA · Cas pratique
Comment faire un clip vidéo avec l'IA
Le clip de « You'll Never Know » a été réalisé avec plusieurs outils d'intelligence artificielle, mais jamais en pilote automatique : un humain décide, l'IA prépare, vérifie et assemble. Voici la méthode complète, étape par étape, avec les outils utilisés et ce qu'ils ont coûté.
You'll Never Know · clip officiel
Sur une terrasse de café, Sofia comprend que son compagnon n'a d'yeux que pour une autre. Pas de scène : elle glisse un mot sous sa tasse et s'en va, le cœur léger. Une rupture racontée en comédie douce, en couleurs chaudes.
Le making-of animé.
Cette animation résume la méthode. Elle a elle-même été codée en HTML par Claude, et sa voix off a été générée avec Voxtral, le modèle de synthèse vocale de Mistral AI. Cochez « Pause à chaque étape » pour la suivre à votre rythme.
Créer un clip avec l'IA en 8 étapes.
Le principe : on prépare tout sur le papier, puis en images fixes, et on ne passe à la vidéo qu'à la fin. Une image se corrige facilement ; une vidéo ratée coûte des crédits, et parfois tout le montage.
- 01
Partir de la chanson et de ses paroles
Tout commence avec la chanson, ici la version rap de « You'll Never Know », sur l'album Can You Rap ?. Comme toutes les chansons de Sofia, elle part d'un texte écrit par un humain, retravaillé avec l'IA, puis mis en musique avec Suno.
On donne à l'IA les paroles et le fichier audio. Un outil de transcription repère à quel moment exact chaque mot est chanté, au centième de seconde. Ces repères servent ensuite à découper le clip en plans et à synchroniser les lèvres.
- 02
Écrire le storyboard
Le storyboard, c'est le clip découpé plan par plan, un peu comme une bande dessinée. Pour chaque plan, on note ce qu'on voit, les paroles chantées, la durée, et s'il s'agit d'un plan chanté (Sofia chante face caméra) ou d'un plan d'histoire (l'action avance).
Pour « You'll Never Know », cela donne 35 plans pour 3 minutes, dont 15 plans chantés. Chaque plan a sa fiche dans une petite application créée avec Claude. On y fixe aussi le ton : un clip lumineux, une comédie douce aux couleurs chaudes, même pour une chanson de rupture.
- 03
Fixer une bible visuelle
C'est le secret de la cohérence. Les générateurs d'images ne se souviennent de rien d'une image à l'autre : sans repères imposés, le visage, la coiffure ou le décor changent à chaque plan.
La bible visuelle regroupe ce qui ne doit jamais bouger : une fiche personnage (visage, taches de rousseur, côté de la queue de cheval), une planche de décor (la terrasse et son enseigne) et l'accessoire fil rouge, ici une grande tasse de thé. Les mêmes phrases sont recopiées mot pour mot dans chaque prompt.
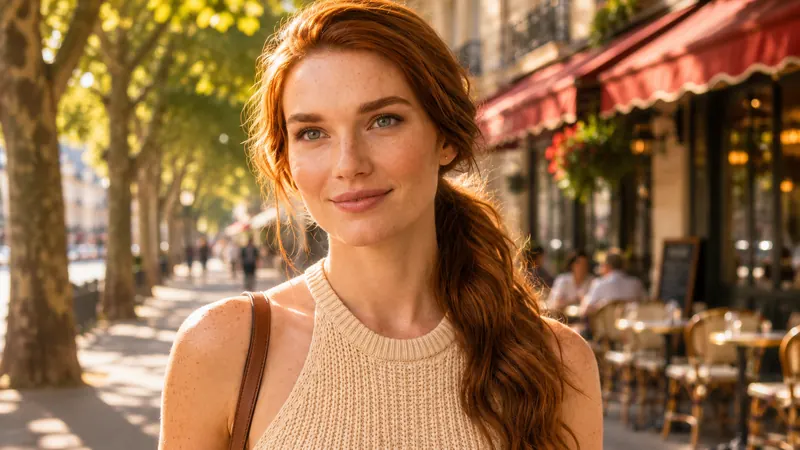
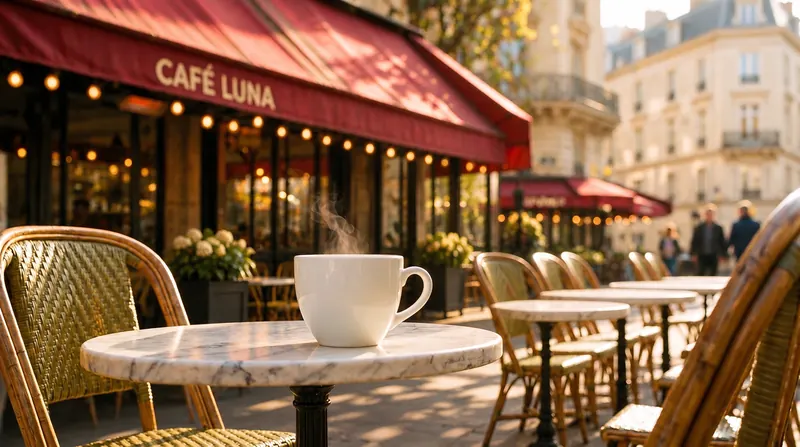
Deux références de la bible visuelle : la fiche personnage et la planche décor, avec la tasse fil rouge. - 04
Écrire les prompts et faire une maquette
Pour chaque plan, Claude rédige un prompt, c'est-à-dire la description précise de l'image à générer : cadrage, expression, décor, lumière. Des brouillons à quelques centimes permettent de vérifier que les plans s'enchaînent bien avant de produire les vraies images.
Pierre génère ensuite les images définitives dans Google Flow, à partir des prompts et des références de la bible. Une astuce : écrire aussi ce qu'on ne veut pas (« pas de bijoux », « aucun autre mot sur l'enseigne »), sinon l'IA invente.
- 05
Vérifier la cohérence, image par image
C'est l'étape la plus importante, et la plus souvent oubliée. Chaque image est comparée à celle d'avant et à celle d'après : même visage, même tenue, même lumière, même décor, textes lisibles et corrects.
Sur ce clip, la revue a par exemple repéré un store rouge vif au lieu du store bordeaux du café, une tasse bien trop grande et des taches de rousseur trop marquées sur un plan. On corrige à ce stade : une fois la vidéo générée, chaque erreur se paie en crédits.
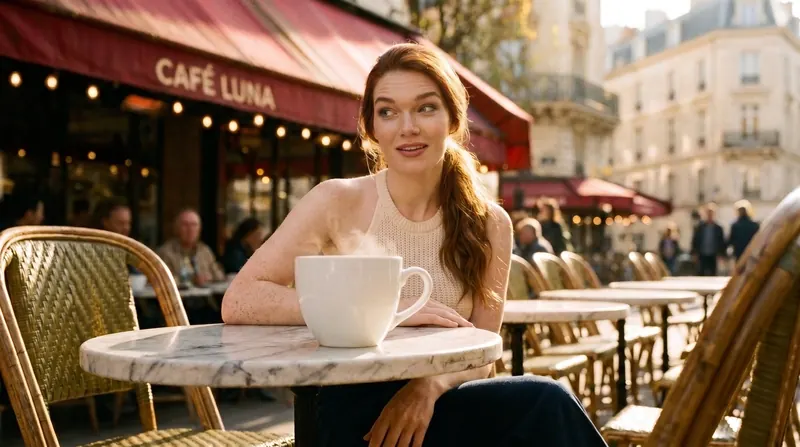
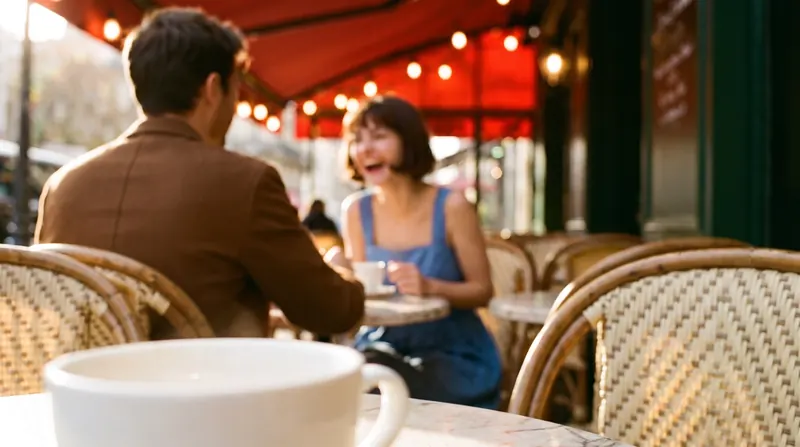
Vue « raccord » : le plan 3, au centre, a un store rouge vif au lieu du store bordeaux, et une tasse trop grande. - 06
Transformer les images en vidéos
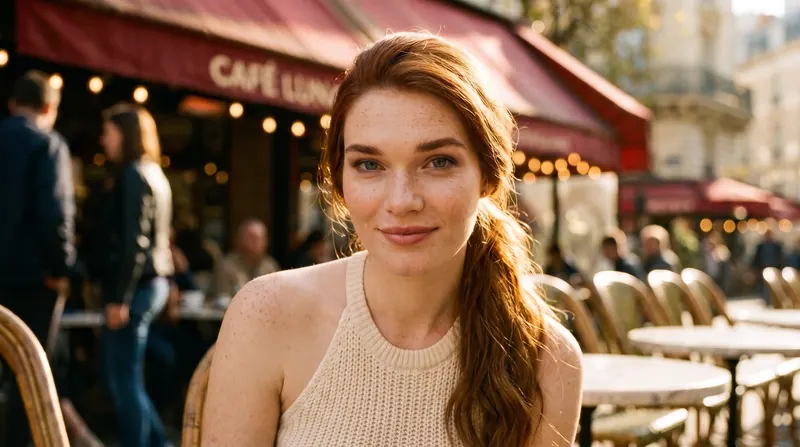
Une fois toutes les images validées, on les anime. Les plans chantés passent par un modèle de lip sync, MiniMax H3 : à partir d'une image et d'un extrait de la chanson, il fait bouger les lèvres de Sofia en rythme avec sa voix.
Les plans d'histoire (marcher, se lever, glisser un mot sous une tasse) sont animés dans Google Flow. La règle : une seule génération par plan, un geste simple et une caméra fixe.
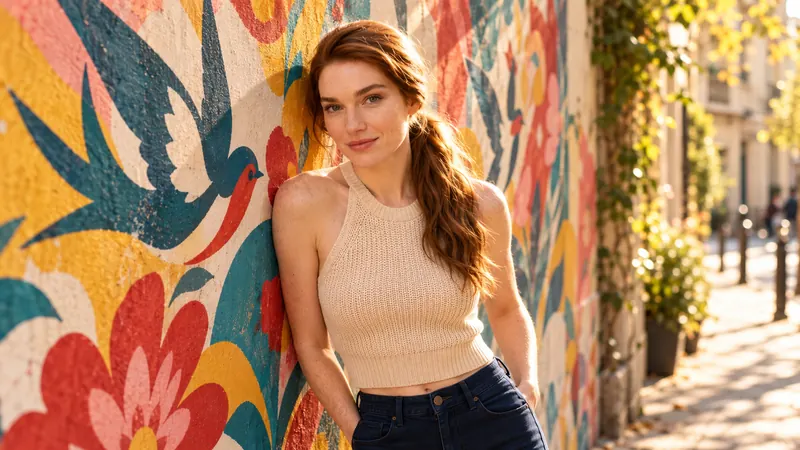
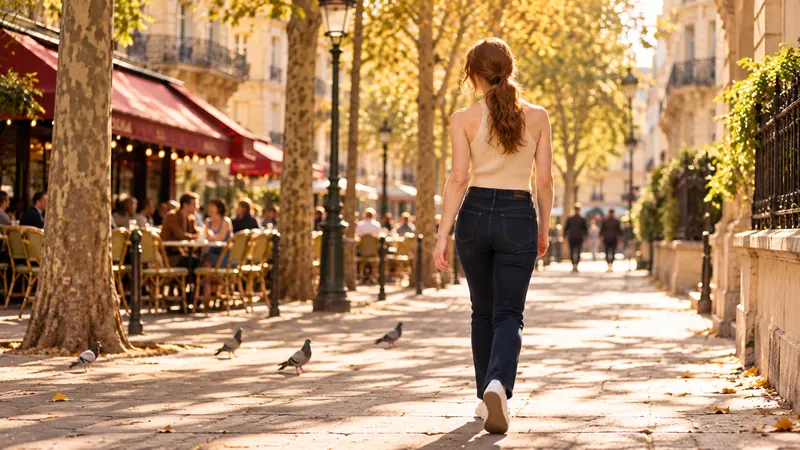
À gauche, l'image de départ d'un plan chanté (lip sync) ; à droite, un plan d'histoire animé dans Google Flow. - 07
Monter et synchroniser
Claude assemble les plans sur la piste audio avec ffmpeg, un logiciel de montage en ligne de commande, en calant chaque plan à l'image près. Il ajoute les paroles à l'écran au bon moment.
Il décline ensuite le clip en version verticale 9:16 pour TikTok, Instagram Reels et YouTube Shorts.
- 08
Publier
Dernière étape : trois vignettes YouTube à tester, des sous-titres en français et en anglais, une boucle de 8 secondes pour Spotify Canvas et un texte adapté à chaque réseau social. Pierre choisit et publie.
Les outils utilisés pour ce clip.
| Étape | Outil | Usage | Coût |
|---|---|---|---|
| Chanson | Suno | Musique et voix chantée | Abonnement |
| Transcription | ElevenLabs Scribe v2 (via fal) | Horodatage des paroles, au mot près | Quelques centimes |
| Storyboard, prompts, vérifications, montage | Claude (Anthropic) | Préparation et contrôle de chaque étape | Abonnement |
| Images | Google Flow | Images de référence et de chaque plan | Abonnement Google |
| Images (appoint) | ChatGPT | Remplacements ponctuels | Abonnement |
| Plans chantés | MiniMax H3 lip sync (via fal) | Synchronisation des lèvres, en 768p | 0,05 $ par seconde |
| Plans d'histoire | Google Flow | Animation des images | Crédits de l'abonnement |
| Montage | ffmpeg | Assemblage, synchro, version 9:16 | Gratuit |
| Voix off du making-of | Mistral Voxtral TTS | Voix « Léa » | Quelques centimes |
Le seul poste payé à l'usage est fal, la plateforme qui donne accès à MiniMax H3 et à la transcription : environ 18,50 $ sur le mois d'octobre 2026, essais compris, dont 12,80 $ pour les plans chantés en lip sync. Le reste passe par des abonnements déjà en place : Suno, Google et Claude.
Ce que ce clip nous a appris.
La ressemblance vient de l'image de départ.
Pas de la résolution de la vidéo : le 768p suffit pour le lip sync.
Remplacer un plan à partir de son voisin.
On retouche l'image d'un plan voisin. Une image neuve, surtout d'un autre générateur, crée un saut de couleurs et de visage.
Montrer les objets plutôt que les décrire.
Donner la tasse en image de référence est la seule façon de la garder identique d'un plan à l'autre.
Soigner le cadrage des plans chantés.
Visage à environ un tiers de la hauteur, bouche bien visible, mains posées : des mains libres donnent des gestes étranges.
Écrire les textes visibles mot pour mot.
« CAFÉ LUNA », aucun autre mot : sinon l'IA invente, comme ce « CAFÉ LUNA CONE » repéré sur un plan.
Éviter les ralentis.
Les images intermédiaires deviennent floues. Mieux vaut choisir la bonne durée dès la génération.
Faire un clip avec l'IA : vos questions.
Combien coûte un clip vidéo réalisé avec l'IA ?
Pour ce clip de 3 minutes, la génération payée à l'usage (sur fal) a coûté environ 18,50 $ sur le mois, essais compris, dont 12,80 $ pour les plans chantés en lip sync. Le reste passe par des abonnements existants : Suno pour la musique, Google pour les images et Claude pour la préparation et le montage. Le vrai investissement, c'est la direction artistique et la vérification.
Comment garder le même personnage d'un plan à l'autre ?
Avec une bible visuelle : une fiche personnage, une planche de décor et les accessoires en images de référence, plus les mêmes phrases recopiées dans chaque prompt. Ensuite, chaque image est comparée à ses voisines avant de passer à la vidéo.
Quel outil utiliser pour faire chanter un personnage (lip sync) ?
Pour ce clip, MiniMax H3 en mode lip sync, via la plateforme fal : on lui donne une image et un extrait audio, il renvoie une vidéo synchronisée. Garder une demi-seconde de marge après le dernier mot améliore l'articulation.
Faut-il savoir monter ou coder ?
Non. Le montage est piloté par Claude à partir de consignes en français. Ce qui compte, c'est de savoir ce qu'on veut voir, et de vérifier.
L'IA fait-elle tout toute seule ?
Non. L'humain garde la direction artistique : l'histoire, le ton, le choix et la validation de chaque image. L'IA aide à préparer, à vérifier et à assembler.
Apprendre à le faire.
Ces méthodes sont au programme des conférences et des ateliers sur l'IA animés par Pierre-Etienne Noble.